Monorepo vs Polyrepo : avantages et inconvénients clés
Résumé
Monorepo ou polyrepo : la décision ne se prend pas par préférence d'équipe, elle se mesure. Le cycle PR médian est 9,5x plus lent en monorepo (19h vs 2h selon Faros AI). Le blast radius est différé en polyrepo, atomique en monorepo. La règle des 30% donne un seuil actionnable : si plus de 30% de vos features touchent plusieurs services, la taxe de coordination polyrepo finit par dépasser l'investissement outillage monorepo.
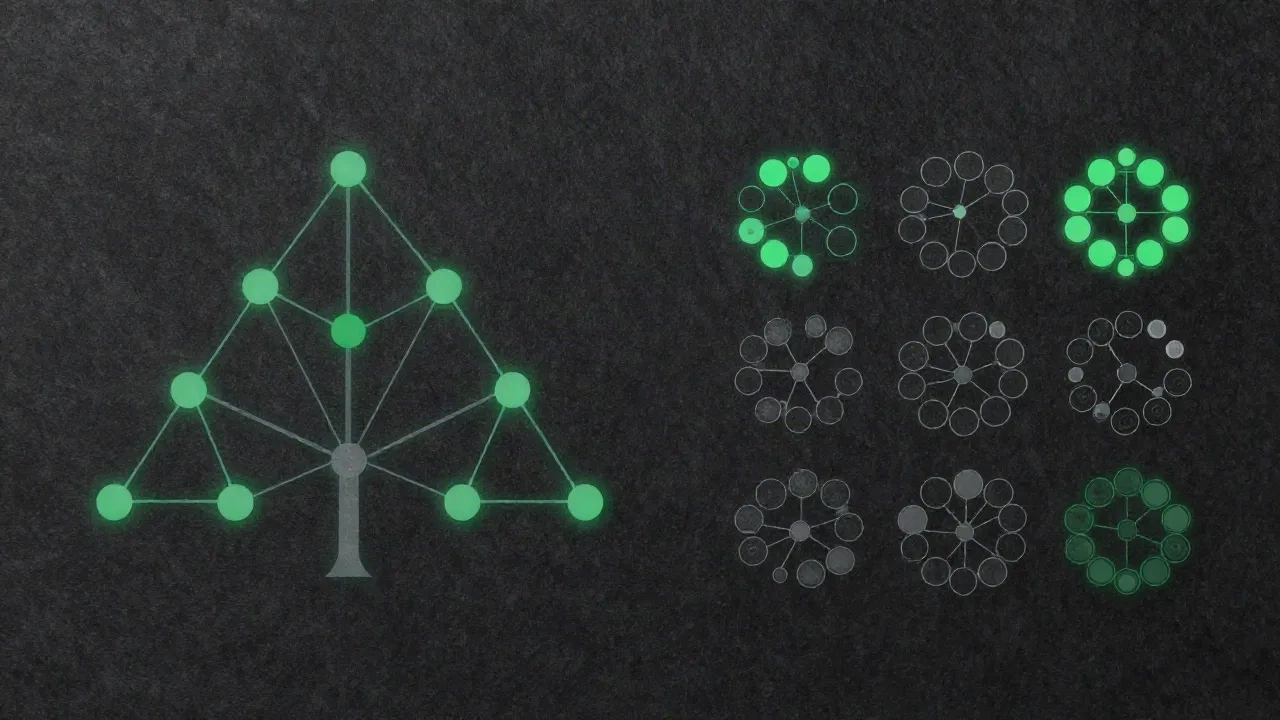
Le débat monorepo vs polyrepo avantages inconvénients se résume à une mesure, pas à une opinion : quel pourcentage de vos fonctionnalités nécessitent des modifications au-delà d'une seule frontière de service ? En dessous de 30%, le polyrepo vous coûte généralement moins cher. Au-dessus de 30% et en hausse, la taxe de coordination du polyrepo finit par dépasser l'investissement outillage du monorepo.
Si vous ne connaissez pas ce chiffre, vous prenez une décision d'infrastructure sur les préférences de votre équipe plutôt que sur des données. Et dans une organisation de 50 ingénieurs, cette préférence coûtera à quelqu'un un dimanche.
Les deux approches imposent des coûts. La question est de savoir lesquels votre organisation peut le mieux absorber : la taxe de coordination du polyrepo ou l'investissement outillage du monorepo.
Les données de cycle PR devraient trancher. Elles ne le font pas
Faros AI a analysé 320 équipes engineering sur 12 mois et établit que les environnements monorepo ont un temps de cycle PR médian de 19 heures. Les environnements polyrepo : 2 heures.
C'est un écart de 9,5x à la médiane. Au 90e percentile, l'écart se resserre : 8,6 jours pour le monorepo contre 5,5 jours pour le polyrepo - mais les deux queues sont lentes. La moyenne suit le même mouvement : 3,6 jours en monorepo, 2,8 jours en polyrepo.
L'argument inverse est bien documenté : les monorepos bénéficient de builds individuels plus rapides quand le cache fonctionne. Une équipe polyrepo qui coordonne un changement cross-service sur cinq dépôts, avec cinq pipelines CI distincts et cinq ensembles de CODEOWNERS à valider, ne fermera pas non plus un PR en deux heures.
Les données capturent les temps de cycle des PRs typiques, pas les pires cas de changements transversaux. Cette distinction compte. Les équipes polyrepo citent leur médiane (rapide, parce que la plupart de leurs PRs sont isolés). Les défenseurs du monorepo citent la douleur de coordonner sur plusieurs dépôts (réelle aussi, documentée dans leurs queues de cas extrêmes). Les deux camps ont raison sur des scénarios différents.
Les données ne tranchent pas le débat. Elles décrivent le compromis avec plus de précision que les impressions.
Le blast radius que vous ne calculez pas
Voici ce qui n'apparaît presque jamais dans les talks de conférence : dans un monorepo, une dépendance partagée cassée se propage instantanément à tous les services qui l'importent, dans le même commit, avant même qu'un responsable downstream ait reviewé la modification.
Dans un polyrepo, une version cassée de package ne brise que les services qui la mettent à jour - et seulement quand ils le font. Le blast radius est différé et borné par le choix des consommateurs.
Ce point est critique pour les rollouts avec SLO gates. Une bibliothèque partagée défectueuse dans un monorepo ne vous accorde pas de fenêtre canary. Elle vous offre un blast radius cross-service sur un seul événement de déploiement. Votre budget d'erreur commence à brûler sur plusieurs SLOs simultanément avant que votre automatisation de rollout détecte le pattern et déclenche un revert.
Dans un polyrepo, le déploiement d'un changement de dépendance partagée est naturellement séquentiel. Le service A monte en version et vous observez son SLO. Le service B monte trois jours plus tard. Le blast radius à tout moment est borné par ceux qui ont déjà adopté le changement.
La question n'est pas de savoir quelle structure est intrinsèquement plus sûre. C'est : quel est votre primitif de déploiement ? Si votre unité de déploiement est le service avec son propre SLO gate, le polyrepo offre une isolation naturelle. Si votre unité est le changement de fonctionnalité atomique qui atterrit de manière cohérente sur le frontend, l'API et le worker en arrière-plan simultanément, le monorepo vous donne cette coordination sans dérive de versioning.
La plupart des équipes qui livrent des microservices ont le premier problème. La plupart de celles qui livrent une surface produit fortement couplée ont le second.
Pourquoi les équipes polyrepo heurtent un mur de coordination à 50 ingénieurs
La taxe de coordination se cumule. À 8 ingénieurs, gérer quatre dépôts est pénible mais faisable. À 50, c'est un travail à mi-temps pour plusieurs personnes.
Signaux concrets que la surcharge de coordination polyrepo est devenue structurelle :
Votre équipe plateforme maintient un dépôt de bibliothèques partagées dont personne n'a la propriété claire
Le versioning entre services a suffisamment dérivé pour qu'une montée de version de la bibliothèque partagée devienne un projet de deux semaines
Un nouvel ingénieur ne peut pas être productif sans comprendre lequel de vos 23 dépôts cloner en premier
Les patchs de sécurité sur les dépendances partagées nécessitent des PRs coordonnés sur une douzaine de dépôts, avec un tableur de suivi
Ces pathologies ne sont pas inventées. Ce sont des modes d'échec documentés chez des équipes qui ont atteint 80 ingénieurs et regardé en arrière leurs décisions de structure de dépôts avec des regrets.
Le polyrepo fonctionne quand les équipes sont réellement indépendantes : cycles de release différents, stacks techniques différentes, rotations on-call séparées. Quand les équipes partagent suffisamment de code qu'un changement dans un service nécessite de raisonner sur trois autres, l'isolation achetée par le polyrepo devient le mécanisme qui rend la coordination douloureuse.
Le signal organisationnel : comptez le nombre de canaux Slack créés spécifiquement pour coordonner les releases cross-dépôts. Si la réponse est supérieure à zéro, vous payez déjà la taxe de coordination de manière structurelle.
Ce que les monorepos coûtent vraiment au 95e percentile
Les données P90 de Faros AI sont instructives : 8,6 jours pour les PRs monorepo au 90e percentile. Ce n'est pas une équipe lente - c'est la conséquence structurelle de larges changements transversaux nécessitant une coordination entre plusieurs propriétaires de code, des matrices CI plus larges, et des cycles de review qui traversent les frontières organisationnelles.
Google a Bazel. Meta a construit Buck. Nx Cloud et Turborepo remote cache existent parce que l'investissement outillage pour faire performer un monorepo n'est pas négligeable. Un monorepo à 200 ingénieurs sans sélection de build par impact, cache distribué et merge queue automatisée produit des runs CI de 45 minutes sur des PRs qui touchent une fonction utilitaire partagée.
Le coût outillage est réel et systématiquement sous-estimé. Les équipes qui opèrent avec succès des monorepos à grande échelle ont généralement recruté des ingénieurs plateforme focalisés spécifiquement sur cette infrastructure. Greffer du tooling monorepo sur une base de code en croissance tout en livrant du produit est une friction qui apparaît dans la fréquence de déploiement avant d'apparaître dans un post-mortem.
Si votre équipe plateforme est déjà sous tension, ajouter la maintenance du tooling monorepo est un engagement significatif - pas un choix de configuration.
La règle des 30% que les équipes performantes appliquent vraiment
Une heuristique utile issue des équipes qui ont pris cette décision de manière délibérée : si plus de 30% de vos fonctionnalités nécessitent des modifications sur plusieurs frontières de service, la surcharge de coordination d'un polyrepo finira par dépasser l'investissement outillage d'un monorepo bien géré.
En dessous de 30% - là où se situent la plupart des organisations microservices - les avantages d'isolation du polyrepo l'emportent généralement sur la taxe de coordination. Les changements cross-services surviennent, mais pas assez fréquemment pour que l'outillage partagé amortisse plus vite que l'isolation.
Ce chiffre est mesurable. Reprenez vos six derniers mois de PRs mergés et comptez combien ont nécessité des modifications dans plus d'un dépôt pour livrer une seule fonctionnalité visible utilisateur. Ce ratio est votre donnée d'entrée. Il ne sera pas précis au décimal, mais il sera directionnel - et directionnel suffit pour arrêter le débat qui tourne sur les préférences d'équipe.
Une équipe à 12% de taux cross-service n'a pas besoin d'un monorepo. Une équipe à 38% et en hausse paie une taxe de coordination qui continuera à s'aggraver.
La stratégie de rollout change le calcul
Il y a une dimension de cette décision qui reçoit presque aucune couverture : votre primitif de rollout.
Si vous opérez des rollouts à pourcentage avec SLO gates - livrer une fonctionnalité à 5% du trafic, surveiller les budgets d'erreur, puis étendre progressivement - votre calcul de blast radius change selon que la fonctionnalité couvre un service ou plusieurs.
Dans un polyrepo, un rollout de fonctionnalité multi-services nécessite de coordonner l'état du rollout entre services. Le service A peut être à 20% pendant que le service B est encore à 0%, créant des états incohérents difficiles à analyser sous pression d'incident. Les feature flags aident, mais vous gérez toujours un état de flags cross-service sans source de vérité unique pour la progression du rollout.
Dans un monorepo avec des commits atomiques, la fonctionnalité atterrit de manière cohérente entre les services. Le rollout peut toujours être à pourcentage au niveau infrastructure, mais le code est cohérent dès l'instant du déploiement. Vos SLO gates se déclenchent sur un état cohérent.
Les équipes qui livrent beaucoup de fonctionnalités atomiques multi-services, avec rollback automatique sur violation de SLO, trouvent souvent que la cohérence du monorepo élimine toute une catégorie d'incident que le polyrepo n'a pas de nom propre pour désigner : l'incident de divergence d'état cross-service qui ressemble à un bug mais est en réalité un problème de coordination de déploiement.
Ce que le post-mortem dira vraiment
La plupart des organisations engineering finissent sur un hybride que personne n'appelle hybride parce que ça ressemble à un compromis architectural.
Un ou deux monorepos pour les surfaces produit fortement couplées. Des dépôts séparés pour les services véritablement autonomes avec des cycles de déploiement indépendants, leur propre rotation on-call, et une équipe qui n'a pas eu besoin de coordonner un changement de bibliothèque partagée depuis six mois.
Les signaux pour reconsidérer votre structure actuelle :
La fréquence des changements cross-services a dépassé 30% et les temps de CI s'allongent
Vous avez recruté des ingénieurs plateforme avec la capacité d'investir dans le tooling monorepo
Un incident de blast radius a révélé que l'isolation de votre polyrepo était illusoire : les services partageaient assez d'infrastructure pour que l'isolation soit un confort, pas une sécurité
Les signaux que la situation est correcte pour l'instant :
Les équipes sont réellement indépendantes et la surcharge de coordination est faible
Votre pire incident n'a pas été causé par la dérive de dépendances cross-services
La capacité d'ingénierie plateforme n'existe pas pour maintenir le tooling monorepo sans ralentir la livraison produit
Le post-mortem vous dira lequel de ces cas vous vivez réellement. Ce document est généralement plus honnête que l'architecture decision record qui a précédé le système qu'il décrit.